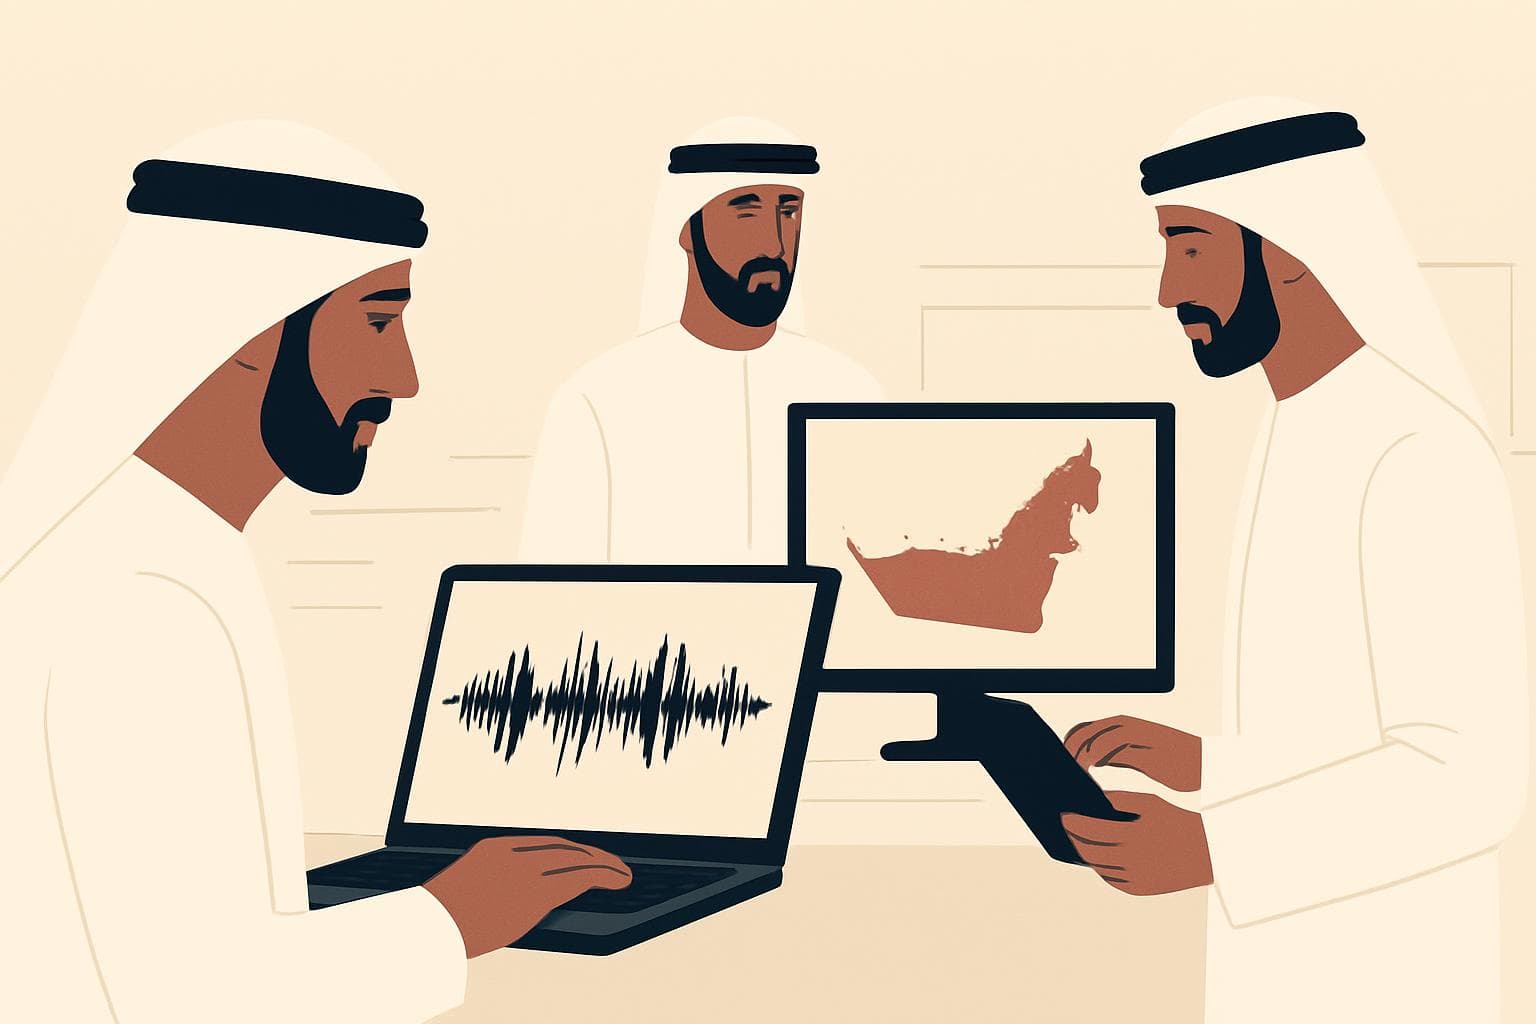
Abu Dhabi állami kutatóintézete, a Technology Innovation Institute (TII) olyan mesterséges intelligencia-modelleket adott ki, amelyeket kifejezetten az emirátusi arab dialektusra képeztek. A bejelentés szerint a csomag célja a fordítási, átírási és beszédfelismerésen alapuló szolgáltatások pontosságának javítása a helyi nyelvhasználat és kulturális utalások figyelembevételével.
A kiadott eszközök
A TII közlése alapján a publikált eszközök között szerepel a Falcon-Emirati elnevezésű nyelvi modell, valamint beszédfelismerésre és képekből, dokumentumokból történő arab szövegkinyerésre szolgáló megoldások. A szervezet hangsúlyozza, hogy ezek az eszközök viszonylag kompaktak: például a beszédfelismerő modell 1,6 milliárd paraméterrel rendelkezik, és a TII szerint pontosabb, mint egy 30 milliárd paraméteres modell.
Miért fontos ez?
Az arab nyelv mesterséges intelligencia általi tanítása elmaradt más nyelvek mögött, részben azért, mert az arab dialektusok jelentősen eltérnek egymástól. Sok dialektus azok számára is nehezen érthető, akik csak a modern standard arabot ismerik, amelyet híradókban és tankönyvekben használnak. A nyelvi különbségek miatt a gépi fordítások gyakran pontatlanok lettek, néha kulturálisan kínos vagy sértő eredményeket adva az angol nyelvű kimenetben.
A TII célja, hogy ezeket a hibákat megszüntesse azáltal, hogy a modelleket a helyi dialektusokra, idiómákra és kulturális utalásokra tanítja. Ennek eredményeként az AI szolgáltatások használhatóbbá válhatnak a régióban, és csökkenhet a félreértésekből adódó problémák száma.
Hatás és további kilátások
A TII lépése az arab nyelvű AI-fejlesztés felzárkóztatására irányuló szélesebb törekvések része. A kompakt, dialektus-specifikus modellek bevezetése ésszerűbbé teheti a helyi alkalmazásokat mind a vállalati, mind a közszféra számára, különösen olyan területeken, ahol a pontos beszédfelismerés és a helyes nyelvi kontextus kulcsfontosságú.
Mohammed Sergie