Az AI Engineer New York (AIE NYC) konferencián rögzített beszélgetésben Evan Conrad, a SF Compute vezérigazgatója arról beszélt, hogyan próbálja a vállalat a felhő és a futures-kereskedelem analógiáit összekapcsolni a GPU-piacon: nem pusztán árórákat kereskedni, hanem tényleges, használható számítást fizikailag leszállítani („physical settlement”).
Mi változott: szoftveres hálózattól a programozható adatközpontig
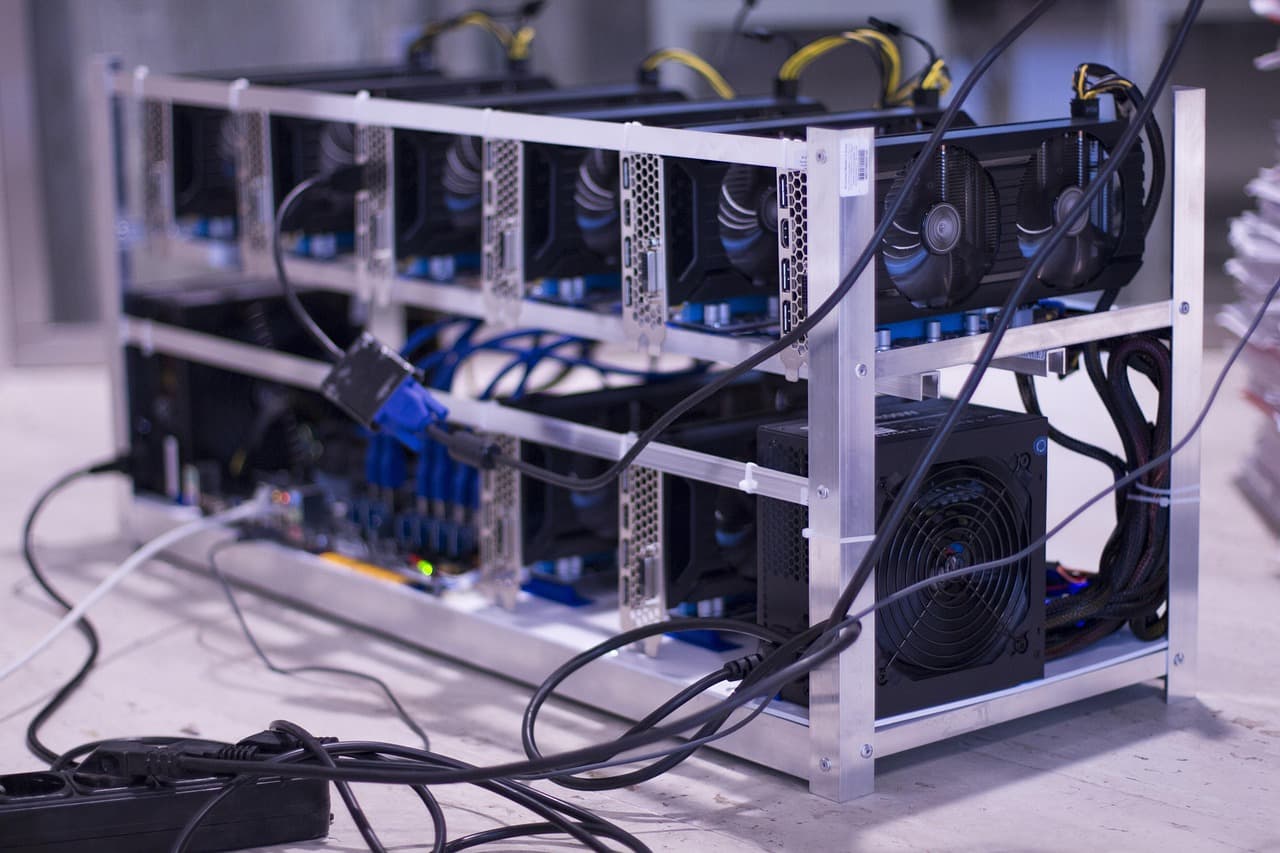
A szerkesztők a beszélgetésben Martin Casado korábbi áttörő munkáját idézték — a software‑defined networkinget, amely virtualizálta a routingot és amelyért a Cisco 600 millió dollárt, a VMware 1,3 milliárd dollárt ajánlott. Conrad szerint hasonló forradalom zajlik most a GPU-knál: korábban egy saját szuperszámítógép‑klyszter kiépítése 50–100 millió dolláros kezdő beruházást igényelt, ma pedig SF Compute lehetővé teszi, hogy GPU‑órákat adjanak-vegyenek most és jövőre, miközben programozottan vezérelhetővé teszik a hálózatot, memóriát és egyéb üzemeltetési rétegeket.
A "szoba eladása" helyett: a hotel üzemeltetése
Conrad egy hotel-analógiával írta le a céget: kezdetben a csapat megpróbált egy klasztert albérletbe adni, de az ügyféligények (takarítás, szobaszerviz, biztonság) miatt hamar kiderült, hogy a teljes üzemeltetést kell vállalniuk — azaz a „hotelt” kell üzemeltetniük. Az elmúlt években ezért inkább a felhő működtetéséhez szükséges üzemeltetési kapacitás nagy részét építették meg, hogy megbízható módon tudják leszállítani a kereskedett compute‑ot.
Ez a fizikai elszámolás lényege: a vevő valóban használható számítást kap, nem csak egy pénzbeli kompenzációt egy index ellenében. Ennek következménye, hogy a klaszter fizikai korlátai — megszakítható-e a munkaterhelés, milyen gyorsan lehet helyreállni tárolóból, mely GPU-generáció vagy hálózati konfiguráció szükséges — közvetlenül befolyásolják a szerződés feltételeit és az árazást.
Hogyan lesz a compute kereskedhető?
A SF Compute nem várja meg, hogy minden GPU‑klaszter teljesen felcserélhető legyen. Ehelyett többrétegű rendelési könyvet hoztak létre: a vevők különböző feltételeket (időablak, megszakíthatóság, GPU‑generáció, tárolási háttér stb.) adhatnak meg, és a matching motor ezek alapján párosít. Ez lehetővé teszi a likviditás generálását anélkül, hogy előzetesen standardizálni kellene minden technológiai részletet, de a likviditás így több variánsra oszlik és a spreadek nagyobbak lesznek.
Conrad szerint jelenleg összes kapacitásuk körülbelül 5%-át tették fel az order bookra; habár az order bookon forgalom még viszonylag kicsi, azon a részen koncentrált likviditás figyelhető meg. Egy gyakorlati mutatójuk: ha egy vásárló 100 dollárt költ kapacitásra, átlagosan körülbelül 25 dollárt vissza tud keresni azzal, hogy a kapacitást továbbadja a piacon.
Mely dimenziók számítanak a gyakorlatban?
A beszélgetés több műszaki és piaci dimenziót emelt ki, amelyek befolyásolják a szerződéseket és az árazást:
- A kapacitás most van‑e használatban vagy jövőbeni időpontra szól (azonnali megszakítás és előre lefoglalt időablak másként értékelendő).
- A megszakítás módja és a tárolóalrendszer: ha a node gyorsan helyreállítható egy Weka vagy Vast típusú háttérrel, másképp árazzák, mint ha a tároló lassú vagy távoli.
- A klaszterek közötti gyors tranzit (WAN/private interconnect) megléte, amely lehetővé teszi a munkaterhelések áthelyezését egyik klaszterről a másikra.
- GPU‑cohorts: egyes GPU‑szállítmányok (például korai H100 vagy GB200 egységek) kezdetben firmware‑ vagy gyártási problémákkal küzdhetnek; a vevők ezért felárat fizethetnek egy bizonyos, későbbi kohorszért, amely már „burn‑in” utáni, stabilabb darabokat tartalmaz.
- Generációk és SKU‑k: a generációk, VRAM‑méretek, NVLink/InfiniBand tartományok mind számítanak; SF Compute SKU‑koncepcióval dolgozik, és lehetőséget ad arra, hogy a vevők nevezett lekérdezésekkel (named query) programatikusan határozzák meg igényeiket.
Spot, forward, batch és live inference; az áralakítás formája
Conrad elmondása szerint a klaszterek finanszírozása általában három–öt évre terjed, és SF Compute különböző időtávú szerződéseket is támogat: azonnalitól több évig terjedő blokkokat. A cég most elsősorban a hosszabb lejáratra (forwards) fókuszál, mert ez a finanszírozási és likviditási görbéhez szükséges. A piacon különbség van batch (megszakítható) és live (folyamatos SLA‑igényű) inferencia között, és ezeket eltérően árazzák: a live munkák megszakítása jóval drágább.
A beszélgetés rávilágít arra is, hogy az árgörbe időben változhat: egyes időszakokban a közelgő kapacitás gyakran olcsóbb, mert a közelgő blokk eladásához árengedményt kell adni (hasonló az "expiring milk" analógiához), máskor a jövőbeli kapacitás lehet drágább, ha a kereslet a rövid távú rendelkezésre állásért fizet.
Példaként elhangzott: egy B300 GPU napi inferenciaértéke elméletileg ~40 USD/óra lehet maximális kihasználtság mellett (részletes körülményektől függően ez ~25 USD/óra-nyi reális bevételt jelenthet), miközben a B300 kapacitás vásárlási költsége 5–6 USD/óra. Ez óriási arbitrázs lehetőséget jelez, és a piaci szereplők viselkedése határozza meg, hogyan záródnak ezek a különbségek.
Függetlenség és a piac üzemeltetőjének szerepe
Conrad hangsúlyozza az operatori függetlenség fontosságát: azok a szereplők, amelyek nagy hardver- vagy inferencia‑üzletet futtatnak (például hyperscalerek vagy nagy szolgáltatók), nehezebben tudnának semleges piacot működtetni, mert üzleti érdekeik torzítanák a piacot. Hasonlóan NVIDIA sem valószínű, hogy közvetlen piac‑üzemeltetővé válna, mert a függetlenség hiánya csökkentené a piacba vetett bizalmat és a finanszírozók lelkesedését.
Műszaki, üzemeltetési feladatok — a "csúnya" munka
A vállalat fizikai elszámolást vállaló szerepe sok kézzelfogható, helyszíni munkát jelent:
- adatközpont‑látogatások és site‑túrák,
- bill of materials tervezése és OEM‑kapcsolatok,
- klaszter‑architektúra tervezése és rack‑kiépítések felügyelete,
- backplane kezelés (PDUs, switch-ek, DPU‑k, UFM, BMC),
- a hálózati/internali fabric dinamikus particionálása (például InfiniBand‑alapú részek újraosztása on‑the‑fly).
Ezeket a feladatokat a SF Compute nem feltétlenül saját adatház‑építéssel végzi, hanem partnerekkel együttműködve, és sok esetben a helyi adatközpont‑tulajdonosokkal partnerségben alakítják ki a felhőhöz hasonló működést. A cég azt ajánlja, hogy ha valaki rendelkezik GPU‑klaszterrel vagy átalakítható adatközpont‑kapacitással, SF Compute át tudja venni a szuperszámítástechnikai részt és rövid úton értékesíthetővé teheti a kapacitást.
Ökoszisztéma és versenytársak
Conrad megemlítette a SemiAnalysis, Silicon Data, Compute Exchange, Jump és más piaci szereplőket; kategóriákat látni: szabványosítással foglalkozók, biztosítást/ residual value megoldásokat kínálók, finanszírozást előtörlesztők. SF Compute fizikai elszámolást vállal, míg mások inkább cash‑settled megoldásokat építenek; Conrad szerint mindkettő létezhet és egymást kiegészítheti, de a cash‑settlementnek a fizikai elszámolásból kellene származnia, hogy elkerüljék az indexmanipulációt és a nagy basis‑kockázatot.
Milyen mérföldköveket említettek?
Conrad szerint a cég több százmillió dollárnyi volumen felett zárt, jelentős számú új klaszter áll beépítés alatt, és olyan funkciókat adtak ki, amelyek platform‑szolgáltatóknak teszik vonzóvá a terméket — például a képességet, hogy az ügyfelek saját maguk osszák fel az InfiniBand fabricet dinamikusan.
Összefoglalás
SF Compute célja, hogy a GPU‑kapacitást ne csak pénzügyi eszközként tüntesse fel, hanem ténylegesen fizikailag leszállítható, programozható adatközpont‑kapacitássá tegye. A cég szerint a fizikai elszámolás és a helyszíni, üzemeltetési szakértelem előfeltételei egy likvid, működőképes compute‑piactérnek; az iparág többi szereplője ezt a folyamatot kíséri, és különböző megoldások (cash vs. physical settlement) párhuzamosan alakulnak ki.
Vendég és források
Beszélgetőtárs: Evan Conrad, a SF Compute vezérigazgatója.
A beszélgetés rögzítve készült az AIE NYC eseményen; a podcast adás és részletesabb jegyzetek, valamint egy automatikus átírás is elérhető volt a házigazdák anyagai között.